
CN

重新定义 AI 推理基础设施
GPNPU 智算架构:融合通用编程与专用效率
面向大模型推理时代
打造的新一代 AI 智算处理器
 高性能计算
 灵活编程
 高效能比
 大模型优化
PRODUCT FORM
产品形态
多元异构计算融合·构建智能算力新生态

GPGPU

GPGPU

近存计算

算力积木
通用性
统一线程执行,真正承接主流开发生态
以 SIMT 通用线程模型和 CUDA 兼容软件栈为基础,支持复杂控制流、动态调度与完整推理流程承载
高效性
通用架构,也能实现 NPU 级效率
通过 SIMD 张量融合计算、混合精度执行与片上显存协同,提升有效算力,吞吐表现与单位功耗产出
低时延
面向实时智能的响应式架构
依托近核热数据驻留、低跳数互连与解码优先调度,显著改善首响应、首Token与尾时延表现
大带宽
以 3D MEMORY 重构数据供给能力
通过 3D 堆叠存储与分层带宽微细化体系,突破传统平面存储限制,支撑长上下文与MoE场景的数据访问需求
超节点 (原生 Scale-Up)
从单芯片走向超节点推理平台
通过统一内存语义的高速互连与系统级扩展架构,支撑从单卡、整机柜到超节点的持续扩展
Technology Architecture Introduction
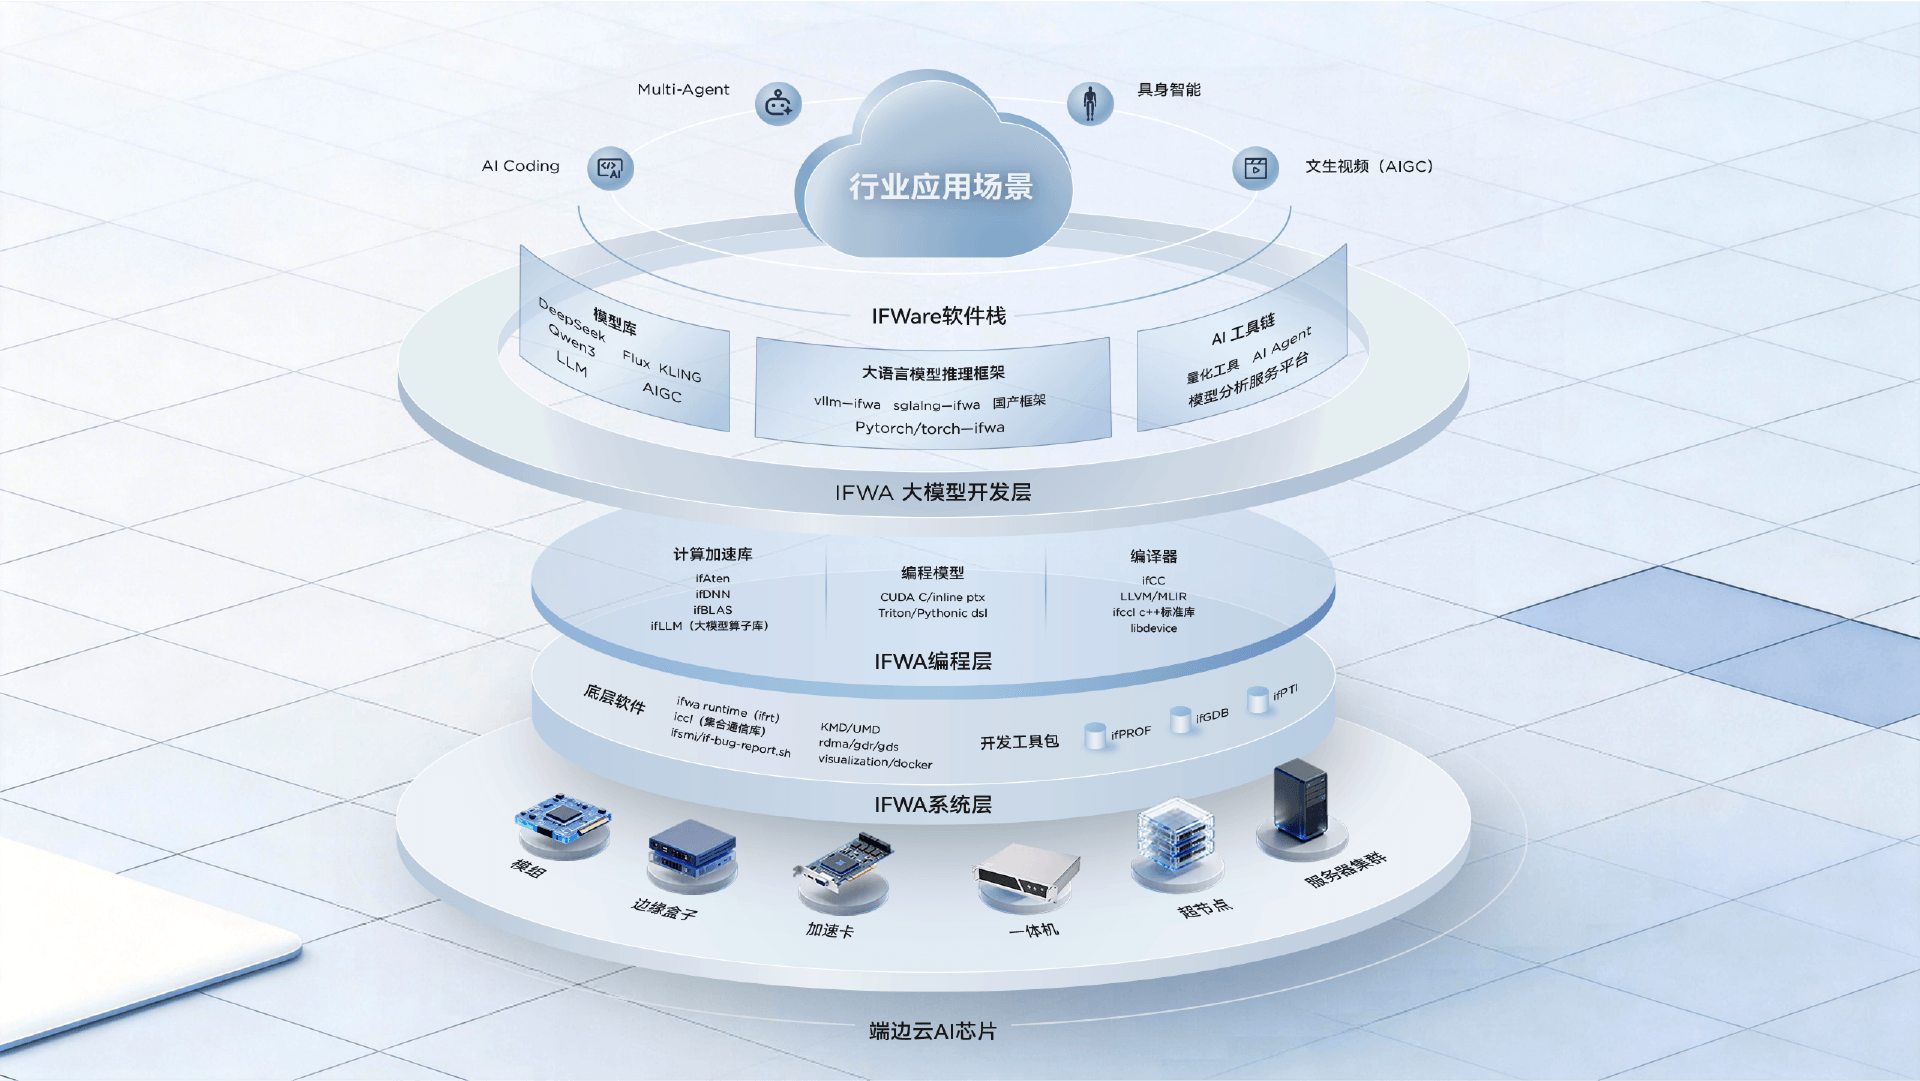
GPNPU 架构软件栈